はじめに
ローカルLLMって、グラフィックボードを2枚挿しても本当に使えるのかな? 今日は導入から動かすところまで、順番に見ていこうよ!
こんばんは、kanatoです。さて、今回はローカルLLM実行環境の「Strata」に、Qwen3.8-Flash-Nextというモデルを入れて動かした記録をまとめたいと思います。
私のPCには、RTX 5060 Ti(16GB)が2枚と、128GBのメモリが載っています。これまでOllamaとQwen Codeでローカルモデルを動かしてきましたが、コンテキストを広げると途中で要約が何度も走り、仕事に使うにはまだ苦しい状態でした。そこで、既存のOllama環境にはいっさい触れず、別の追加環境としてStrataを入れてみました。
導入は2026年10月17日、128K設定の追加は18日に行っています。
1.先に結論:2枚のGPUで動き、日本語の生成もおおむね自然だった
結論から言うと、Strataは公式の手順どおりに入り、RTX 5060 Ti 2枚を使って動きました。日本語の生成もおおむね自然で(簡体字が1か所混ざりました)、約600トークンの文章を、応答全体の時間で割って約39トークン/秒で生成しています。
一方で、Qwen Codeからつないだ最初の送信で、Strataが「NaN」というエラーを返すことがありました。復旧の手順と、入れた回避策は6章に書いています。128Kのコンテキストでも、API直叩きで約12.5万トークンまで動くところまで確認しました。
速度は条件つきで読むのであります! 39トークン/秒は短い質問への応答全体で割った値で、Qwen Codeから送ったときのStrataのログでは、生成速度が55〜77トークン/秒と出ていたのであります。測る場所と条件で数字が変わるので、どちらも出しておくのであります!
2.環境と、この構成を選んだ理由
環境は次のとおりです。
| 項目 | 内容 |
|---|---|
| GPU | RTX 5060 Ti 16GB ×2(ドライバ 610.88) |
| メモリ | 128GB |
| CPU | Ryzen Threadripper 2970WX |
| PCIe | 3.0 x8(--check の表示) |
| OS | Windows 11 |
| 保存先 | NVMe SSDのC:ドライブ(空き128GB) |
Strataの公式READMEによると、対応GPUはNVIDIAのRTX 20〜50シリーズなどでVRAM 12GB以上、メモリは32GB以上、ディスクの空きは約80GBが目安です。私の環境はこの条件を満たしています。
モデルは、Qwen3.8-Flash-Nextの量子化サイズ「IQ2_XS」にしました。公式のモデル選択ページでは、メモリ64GBならIQ2_XSが推奨とされています。IQ2_XSに必要なメモリは、公式ページではRAMとVRAMの合計で約39GBです。導入時の案内には、メモリ使用量は約36GBと出ました。RAM 128GBとVRAM 32GBの私の環境なら、余裕があります。コンテキストは64K、画像の読み取り(Vision)はオフ、GPUは2枚、層の割り振り(layer split)は自動にしています。
保存先には少し迷いました。大容量のD:ドライブが空いていましたが、調べるとUSB接続のHDDでした。Strataは約29GBの参照テーブルをSSDに置いたまま読み出す設計のため、HDDに置くと極端に遅くなると判断し、C:ドライブにしています。導入後のC:の空きは、約128GBから約59GBまで減りました。
3.導入の手順:公式のREADMEどおりに入れた
古いブログ記事の手順ではなく、公式リポジトリのREADMEとdocsを確認してから作業しました。2026年10月16日時点のmainブランチを使っています。
最初に、PCがStrataに対応しているかを確かめます。公式の --check は、環境を調べるだけで何もインストールしません。
START-HERE.bat --check結果は「This PC can run Strata.」でした。GPUが2枚とも「can be used」と表示され、2枚を一緒に使う構成が推奨として出ています。
次に、リポジトリをC:\AI\Strataへ取得し、質問に答える形ではなく、オプションを指定して一度に導入しました。
START-HERE.bat --setup --model IQ2_XS --context 65536 --vision no --gpus 0,1 --layer-split auto --port 8080 --data-dir C:\AI\Strata\Strata-data --no-browser --yes導入では、Python環境(.venv)の作成、エンジンの取得、モデルの取得が順に走ります。モデルは約68GB(2ファイルの合計)、MTPと呼ばれる高速化用の追加層は約6GBです。エンジンのZIPは、SHA-256の照合も通りました。既存のPythonで足りたため、Pythonの追加インストールは発生していません。PATHやCUDAの設定も変えていません。
モデルの読み込み中は、PCが1〜3分ほど重くなると公式に案内されています。128K版を起動し直したときは、ログ上で約40秒でモデルの重みの読み込みが終わり、そのあとまもなく応答できる状態になりました。
4.動作確認:6項目の結果
導入後に、次の6項目を確認しました。
| 確認項目 | 結果 |
|---|---|
| 正常に起動する | 起動した(ready: http://127.0.0.1:8080/v1) |
| 8080番ポートの画面が開く | チャット画面が表示された |
| OpenAI互換APIが応答する | /v1/models が応答(n_ctx 65536) |
| GPU2枚が使われている | 層を2枚に分割(ログ)。VRAM使用量は下表 |
| 日本語で生成できる | 生成できた |
| 速度・VRAM・RAM | 下記 |
/v1/models の応答で、モデル名と64Kのコンテキストが返りました。公開範囲は127.0.0.1のみで、同じネットワークの別のPCからは見えません。
速度とメモリの実測値は次のとおりです(64K設定)。
| 項目 | 値 |
|---|---|
| 生成速度(API直叩き・約600トークン) | 応答全体で約39トークン/秒 |
| 生成速度(Qwen Codeから送信・Strataのログ) | 55〜77トークン/秒 |
| VRAM使用量 | GPU0 約14.9GB/GPU1 約15.9GB |
| Strataのメモリ使用量 | 約38GB |
VRAMの数値には注意が必要であります! GPU1は、Strata起動前から他のアプリが約2.8GBを使っていたのであります。Strataだけの使用量ではなく、GPU1の合計値でありますので、そのつもりで読んでほしいのであります。
質問に対する生成の途中では、GPUの使用率はGPU0が約51%、GPU1が約33%でした。2枚に仕事が分散していることは読み取れます。使用率は生成中の一時点の値なので、処理が長くなったときの傾向は別に見る必要があります。
生成された日本語は、資産形成の基本を800字程度で説明させたところ、自然な文章でした。ただ、「负债(負債)」という簡体字が1か所混ざっていました。量子化サイズを小さくした影響かどうかは確かめていないので、日本語の品質は使いながら見ていきます。
5.Qwen Code Desktopにつなぐ
Qwen Code Desktopには、StrataをOpenAI互換の新しいプロバイダーとして追加しました。既存のOllamaのプロバイダーは、そのまま残しています。
設定の実体は、ユーザーフォルダの .qwen\settings.json です。変更の前に、バックアップを取っています。追加した内容は次の3点です。
modelProviders.openaiにStrataのモデルを追加(接続先はhttp://127.0.0.1:8080/v1、コンテキストは65536)- キーの環境変数を追加(Strata側で認証していないため、中身は適当な文字列でよい)
- 既定のモデルは変更しない(モデルの選択画面でStrataを選ぶ)
追加後、モデルの選択画面に「Strata Qwen3.8-Flash-Next IQ2_XS・64K」が表示され、選べるようになりました。
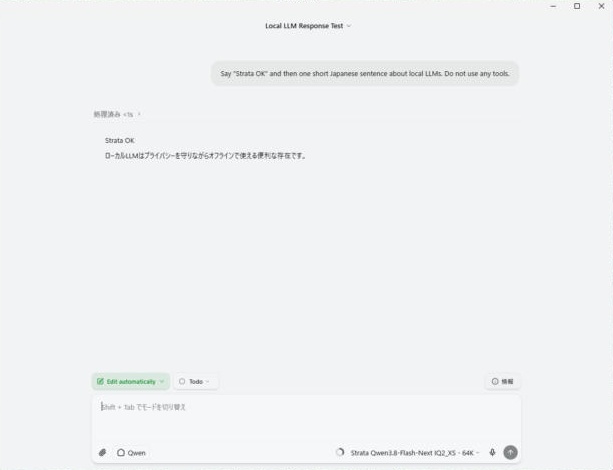
試しに短い質問を送ると、「Strata OK」と日本語の一文が返ってきました。
ここで気づいたのは、Qwen Codeが送る最初のリクエストの大きさです。短い一言を送っただけでも、約22,000トークンの指示(システムプロンプトとツールの定義)が一緒に送られます。Strataは、これを読み込むのに約20秒かかりました。最初の応答まで20秒前後かかるのは、この読み込みの時間です。
6.つまずき:初回のNaNエラーと、入れた回避策
Qwen Codeから最初に送信したとき、Strataが「logits became non-finite(#879)」というエラーを返し、Qwen Code側には503が表示されました。Strataの出力がNaN(数値として成立しない値)になったという意味です。
厄介だったのは、私の環境では、一度失敗するとエンジンの状態が壊れ、短い質問まで503になったことです。私の環境では、Qwen Code Desktopが503のあとも自動でやり直しているように見え、放置すると「作業中」のまま読み込みを繰り返しました。
復旧は次の手順で行いました。
- Desktopの停止ボタンで、実行中のリクエストを止める
- StrataのAPIへ
POST /unload、続けてPOST /loadを送る(Content-Type: application/jsonが必要)
この手順は、公式リポジトリのIssue #879のコメントに、同じ症状の回避策として書かれていたものです。復旧後は、0.5K〜21.6Kトークンまでのリクエストが正常に通りました。
ここから、どんな条件でNaNが出るのかを切り分けました。Qwen Code Desktopから送ると、4回中2回で出ました。一方で、API直叩きでは、同じ前置きの再送、前置きに短い末尾を足す形、ツール定義30個つきのストリーミング、同時送信の4種類で、合計44回試しても再現していません。私の試験では、Qwen Codeの実リクエストでだけ出ている状態です。
失敗した瞬間のログは、毎回「プロンプトの最後の数トークンを読む段階」でした。Strataは、プロンプトの最後の --short-read で指定した分を、通常とは別の経路で読み込みます。Issue #879のコメントに、この値を260にするとNaNが出なかったという報告があったため、設定ファイルのバックアップを取ってから --short-read 260 を追加しました。ただし、その報告はAMDのRadeon(R9700)での検証で、出る条件も約190〜260トークンの短い読み込みでした。報告者はその後、別の検証でROCmのライブラリ側に原因がありそうだとも書いています。NVIDIAの私の環境に当てはまる保証はなく、試しに入れた、という位置づけです。
追加後は、Qwen Code Desktopから新規セッションで5回送って、NaNは出ませんでした。ただし、うち2回は入力欄に意図と違う短い文字列が入った状態で送っています。どの回も約2.2万トークンの指示を読む点は同じですが、厳密に同じ条件ではありません。変更前も半分は成功していたので、5回連続で出なかっただけでは、これで直ったとは言い切れません。当面はこの設定で使い、503が出たら先ほどの復旧手順を使います。
Issue #879そのものは、10月13日に古いIssueの整理を理由にクローズされています。その後の10月19日には、別の利用者が、エージェント用の長いリクエスト(約1.8万トークン・ツール48個)で同じ「プロンプトの最後の5トークン付近」のNaNを再現したと報告しています。その方の環境(RTX 3080)では、プロンプト読み込みの既定の経路を STRATA_PREFILL_MMQ=0 で切り替えると、同じリクエストが通ったそうです。私の環境ではまだ試していないので、次の候補として控えておきます。
7.コンテキストを広げた128K設定
64Kだと、Qwen Codeが最初に使う約22,000トークンのため、作業に使える領域がかなり狭くなります。自動の要約(コンパクション)も、私のQwen Codeの設定では64Kの約75%の地点で始まるため、早い段階で走りやすくなります。
そこで、128K(131072)の設定を別ファイルで作りました。64K版の設定は残しています。違うのは --max-context の値だけです。128Kで起動しても、VRAMの使用量はほぼ変わらず(GPU0が約14.9GB、GPU1が約15.8GB)、Strataのメモリ使用量は約39GBでした。公式docsによると、64K以上ではコンテキストの記憶(KVキャッシュ)の大半をRAM側に置き、VRAMには一部だけを置く設計のためです。
API直叩きでの実測は次のとおりです。
| 試験 | 結果 |
|---|---|
| 約10万トークンの初回読み込み | 74秒(生成 約25トークン/秒) |
| 同じ前置きに、新しい末尾を足す | 6秒前後 |
| 約12.5万トークン | 29秒(前置きの一部は読み込み済み・生成 約41トークン/秒) |
この表も条件つきで読むのであります! 約10万トークンの初回読み込みは74秒、そのあとの生成は約25トークン/秒でありました。約12.5万トークンでは約41トークン/秒と出ていますが、前置きの一部が読み込み済みなど条件が違うので、単純には比べられないのであります。
Qwen Code Desktop側には、128K用のモデルを別に追加してあります。ただし、Desktopから128Kを選んで使う確認は、まだできていません。API直叩きの結果までです。
8.起動と停止は、ショートカットにした
64Kと128Kは、どちらも2枚のVRAMに約30GBを置き、同じ8080番ポートを使います。重ならないよう1つずつ起動する運用にしました。切り替えのたびにコマンドを打つのは面倒なので、デスクトップにショートカットを3つ置きました。
- 「Strata 起動(64K)」
- 「Strata 起動(128K)」
- 「Strata 停止」
起動のショートカットは、動いているStrataを先に止めてから開始します。切り替えは、起動のショートカットを押すだけです。
おわりに
今回の導入で、RTX 5060 Ti 2枚の環境でも、Strata+Qwen3.8-Flash-Next(IQ2_XS)が動くところまで確認できました。速度も、短い質問であれば日常で使える範囲です。一方で、Qwen Codeから使うと、最初の読み込みに20秒前後かかること、NaNのエラーが出ることがあるのが、私の環境で確認できた弱点です。
うーん、動くのはうれしいけど、エラーが出ると不安になっちゃうね……。でも、復旧の手順がわかっているのは心強いよ!
次は、128K設定をDesktopから実際に使い、コンパクションがどのくらい減るかを確かめたいと思います。NaNの回避策が効いているかも、使う回数を重ねて見ていくつもりです。
それでは、良きホビーライフを!
コメント